Tôi làm ngày 23/10/2026. Phần kiểm và vá chạy trên bản sao, hôm sau tôi mới đưa bản vá lên site thật và đo lại, kết quả nằm ở gần cuối bài. Tôi không có số đo việc AI có nhắc tới trang hay không: sitemap mới nộp cho Search Console, chưa có số liệu. Bài chỉ kể tôi kiểm được gì và vá được gì. Nếu máy bạn không có agent, xem bài cài agent trước.
Trước khi vá, phải biết đang thiếu gì
Việc đầu tiên là đo và ghi con số ra, để sau khi vá còn có cái so.
Cả sáu câu lệnh dưới đây tôi giao cho agent mới, mỗi agent chỉ biết đúng câu được giao. Với site thật, agent chỉ đọc. Mọi chỗ sửa nằm trên một bản sao các trang công khai, đặt ở thư mục riêng. Xong việc tôi tự chạy git status trên repo thật để chắc nó không bị chạm.
Bước 1. Bot AI có vào được trang không
Trang chỉ được đọc khi robots.txt cho phép và server không chặn. Tôi bảo agent thử cả hai: đọc robots.txt, rồi gọi trang bằng User-Agent của từng bot.
Câu lệnh 1Kết quả agent trả về
| Bot | robots.txt | Trang chủ | Bài cài agent |
|---|---|---|---|
| GPTBot | cho | 200 (5035 B) | 200 (19531 B) |
| OAI-SearchBot | cho | 200 | 200 |
| ChatGPT-User | cho | 200 | 200 |
| ClaudeBot | cho | 200 | 200 |
| Claude-SearchBot | cho | 200 | 200 |
| PerplexityBot | cho | 200 | 200 |
| Google-Extended | cho | không gọi được | không gọi được |
| Googlebot | cho | 200 | 200 |
| Bingbot | cho | 200 | 200 |
File robots.txt của tôi chỉ có hai dòng có nghĩa: cho phép tất cả, và trỏ tới sitemap. Chín bot đều lọt vào nhóm "tất cả". Tám bot nhận 200, kích thước trả về giống hệt nhau, nghĩa là server không đổi nội dung theo từng bot.
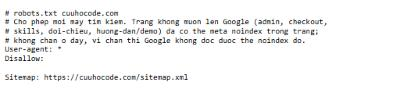
Google-Extended không có User-Agent riêng. Nó chỉ là một dòng trong robots.txt, nên agent không gọi thử được.
Chi tiết kiểm
User-Agent của GPTBot, OAI-SearchBot, ChatGPT-User, PerplexityBot và Googlebot agent lấy từ trang chính thức của từng nhà cung cấp. Của ClaudeBot, Claude-SearchBot và Bingbot nó ghép theo trí nhớ, vì trang chính thức không đưa chuỗi đầy đủ. Phép thử này chạy từ một IP thường. Nếu sau này bạn đặt Cloudflare hay tường lửa kiểm IP thật của bot, bot thật có thể bị chặn mà phép thử này không thấy. Site tôi không có lớp đó, header chỉ ghi nginx.
Bước 2. Kiểm từng trang trong sitemap
Vào được thôi thì không đủ. Máy tìm kiếm và AI còn cần biết trang nói về gì, địa chỉ chính thức là đâu, và đưa lên mạng xã hội thì hiện ra sao. Tôi bảo agent đọc sitemap rồi kiểm từng trang.
Câu lệnh 2Kết quả agent trả về (cả 9 trang trả 200, mỗi trang đúng một thẻ h1)
| Trang | Title | Mô tả | Canonical | og | JSON-LD |
|---|---|---|---|---|---|
| / | 52 | 98 | khớp | không | 0 |
| /huong-dan/ | 21 | 84 | khớp | không | 0 |
| /huong-dan/web-cho-tiem | 63 | 158 | không có | không | 0 |
| /huong-dan/cai-agent | 42 | 133 | khớp | không | 0 |
| /huong-dan/the-danh-gia | 70 | 191 | khớp | không | 0 |
| /san-pham | 20 | 77 | khớp | không | 0 |
| /san-pham-32-loi.html | 61 | 133 | khớp | có | 0 |
| /bo-cuu-ho | 72 | 159 | khớp | có | 1 |
| /hop-tac | 19 | 35 | khớp | không | 0 |
Agent liệt kê: một trang thiếu canonical, bảy trang thiếu og:title và og:description, tám trang không có JSON-LD.
Số đáng để ý là 7 trên 9. Thẻ og là chỗ khung xem trước trên mạng xã hội đọc chữ khi bạn dán link, và 7 trang của tôi không có nó.
Agent còn chỉ ra ba chuyện nhỏ. Mô tả trang Hợp tác chỉ có 35 ký tự. Mô tả bài thẻ đánh giá dài 191 ký tự, vượt mức Google thường hiển thị. Title của hai trang dài hơn 60 ký tự. Mốc 60 và 155 ký tự là quy ước chung của ngành, tôi không tự đo ra. Mấy chỗ này tôi để nguyên, vì sửa là đổi chữ đang hiện trên trang.
Chi tiết kiểm
Tôi tự kiểm lại bằng curl ở bốn trang (trang chủ, trang hướng dẫn, bài cài agent, trang bán): khớp. Tôi không tự đếm lại số ký tự. Agent bỏ qua og:image, hreflang, thẻ robots, và thẻ do JavaScript chèn sau khi tải.
Bước 3. Viết dữ liệu có cấu trúc
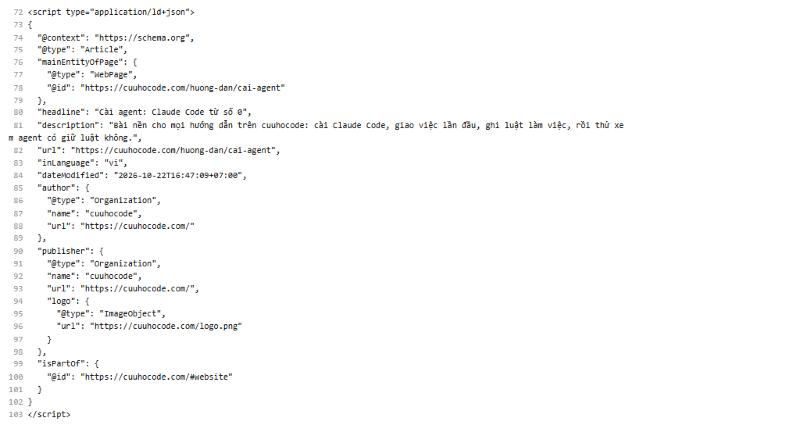
Dữ liệu có cấu trúc, gọi là JSON-LD, là một khối chữ nằm trong trang. Nó nói với máy tìm kiếm trang này là loại gì, của ai, sửa lần cuối khi nào. Người đọc không thấy khối này.
Câu lệnh 3Mẫu agent viết cho bài cài agent (rút gọn)
{ "@type": "Article", "headline": "Cài agent: Claude Code từ số 0", "url": "https://cuuhocode.com/huong-dan/cai-agent", "inLanguage": "vi", "dateModified": "2026-10-22T16:47:09+07:00", "author": { "@type": "Organization", "name": "cuuhocode" } }
Tôi chú ý một chỗ agent không điền: ngày đăng. Sitemap của tôi chỉ có ngày sửa cuối, lấy từ git, chưa chắc đã là ngày đăng. Agent chỉ ghi dateModified và nói thẳng rằng gán ngày sửa thành ngày đăng là bịa. Nó cũng bỏ trường ảnh, vì trang không khai ảnh đại diện nào, và ghi tác giả theo tên site, không ghi tên người.
Chi tiết kiểm
Tôi chạy lại json.load trên cả hai file, đọc được. Việc chọn kiểu tác giả là Organization là agent tự đoán, câu lệnh chỉ nói "theo tên site". Công cụ kiểm của Google (Rich Results Test) tôi chưa chạy. Tôi mới kiểm cú pháp JSON, và khối này cũng không nằm trong trang thật.
Bước 4. Viết llms.txt
llms.txt là một đề xuất: đặt ở gốc site một file chữ thuần, liệt kê các trang quan trọng kèm một dòng mô tả, để AI đọc nhanh. Trước khi làm, tôi muốn biết nó có đáng làm không, nên câu lệnh bắt agent đi tra.
Câu lệnh 4Đầu file agent viết (rút gọn)
# cuuhocode > Skill, hướng dẫn và công cụ để làm việc với AI agent, do một người thử từng thứ rồi ghi lại, kể cả chỗ hỏng. ## Hướng dẫn - [Cài agent: Claude Code từ số 0](https://cuuhocode.com/huong-dan/cai-agent): Bài nền cho mọi hướng dẫn trên cuuhocode: [...]
File có đủ 9 liên kết, đúng 9 địa chỉ trong sitemap, mô tả chép lại từ từng trang.
Phần cuối của câu lệnh mới đáng đọc. Agent không tìm được bằng chứng đáng tin nào cho thấy một nhà cung cấp AI đọc file này khi trả lời. Với Google, nó dẫn một bài tường thuật nói họ không hỗ trợ. Với OpenAI và Anthropic, nó không tìm được tuyên bố chính thức nào. Kết luận của nó: làm thì rất ít công và không hại, nhưng đừng kỳ vọng gì.
Chi tiết kiểm
Phần dẫn nguồn về Google tôi chỉ đọc qua báo cáo của agent, không mở trang nguồn. Câu tóm tắt đầu file do agent tự viết, trong đó có một chỗ nó tự suy ra là "một số sản phẩm có bán". Tôi đọc lại thấy câu đó đúng, và vẫn đưa file lên site thật vì nó chỉ là một file chữ, gỡ lúc nào cũng được.
Bước 5. Vá bản sao rồi đo lại
Tôi chép các trang công khai sang một thư mục riêng, giao cho agent vá, rồi bảo nó đo lại bằng đúng phép đo ở bước 2.
Câu lệnh 5Kết quả agent trả về (thẻ og và JSON-LD, trước rồi sau)
| Trang | Canonical | og | JSON-LD |
|---|---|---|---|
| / | khớp | không, rồi có | 0, rồi 1 |
| /huong-dan/ | khớp | không, rồi có | 0, rồi 1 |
| /huong-dan/web-cho-tiem | vẫn không có | không, rồi có | 0, rồi 1 |
| /huong-dan/cai-agent | khớp | không, rồi có | 0, rồi 1 |
| /huong-dan/the-danh-gia | khớp | không, rồi có | 0, rồi 1 |
| /san-pham | khớp | không, rồi có | 0, rồi 1 |
| /san-pham-32-loi.html | khớp | có sẵn | 0, rồi 1 |
| /bo-cuu-ho | khớp | có sẵn | 1 sẵn, không đổi |
| /hop-tac | khớp | không, rồi có | 0, rồi 1 |
Tôi không tin báo cáo ngay, nên tự đối chiếu. Repo thật không bị sửa: git status chỉ còn những mục vốn đã nằm ngoài git. So từng file với bản gốc thì mỗi file chỉ có thêm 16 đến 36 dòng, không dòng nào bị xoá. Tôi cho một đoạn Python bóc chữ hiển thị của cả 9 trang trước và sau, hai bản giống nhau. Mọi khối JSON-LD đọc được.
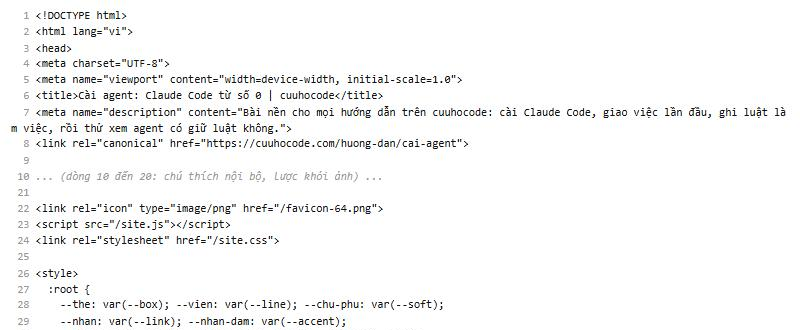
Đây là đầu file bài cài agent, trước và sau khi vá. Tôi dựng một trang xem đơn giản chỉ để hiện đúng chữ trong file bản sao, kèm số dòng. Dòng 10 đến 20 là chú thích nội bộ của tôi nên tôi lược khỏi ảnh.
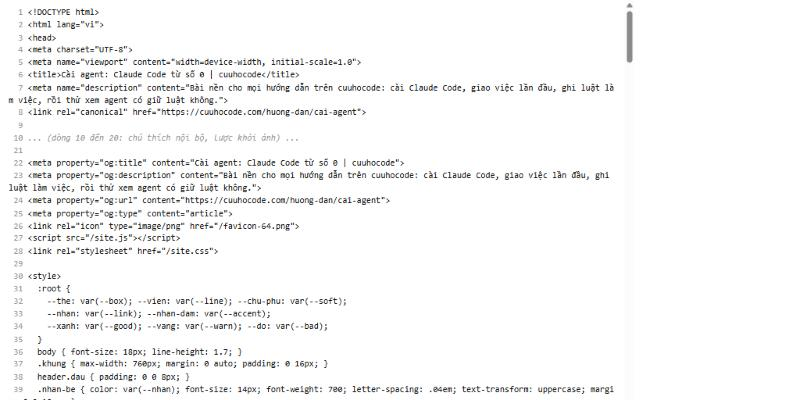
Một chỗ còn thiếu, và lỗi nằm ở tôi. Trang web-cho-tiem vẫn không có canonical, vì câu lệnh của tôi chỉ nhắc thẻ og và JSON-LD. Thêm nó chỉ mất một dòng, nhưng tôi để nguyên để bảng đo thể hiện đúng cái câu lệnh đã làm.
Chi tiết kiểm
Mẫu chỉ có hai kiểu (WebSite, Article), nên agent tự chọn kiểu cho các trang còn lại: CollectionPage cho trang hướng dẫn và trang sản phẩm, ContactPage cho trang hợp tác, Product cho trang 32 Lỗi. Kiểu Product có ghi giá lấy từ chữ hiển thị trên trang. Khai giá với máy tìm kiếm là việc tôi phải tự quyết, nên khi đưa lên site thật tôi bỏ khối giá. Hai trang có sẵn thẻ og trỏ tới một ảnh chia sẻ mà bản sao không có, nên tôi không kiểm được ảnh đó có tồn tại trên site thật không. Phần dựng server nhỏ để chạy bản sao ở máy tôi, tôi không tự chạy lại.
Bước 6. Hỏi web để lấy mốc đầu
Cuối cùng tôi cần một con số nền để sau này so. Cách thô nhất là hỏi web đúng những câu mà người đọc của tôi sẽ gõ, rồi xem site của tôi có hiện ra không.
Câu lệnh 6Kết quả agent trả về
| Câu | Truy vấn | Có cuuhocode.com |
|---|---|---|
| 1 | hướng dẫn cài Claude Code bằng tiếng Việt | Không |
| 2 | cài agent Claude Code từ số 0 | Không |
| 3 | cuuhocode | Không |
| 4 | bộ cứu hộ vibe code | Không |
| 5 | làm thẻ xin đánh giá Google cho nha khoa | Không |
Không câu nào ra site, kể cả câu gõ đúng tên. Công cụ tìm của agent chỉ tìm ở Mỹ, là một công cụ khác Google, và mỗi câu chỉ trả 9 kết quả. Nên bảng này chỉ là một mốc thô để sau so lại. Nó không nói gì về Google ở Việt Nam. Muốn đo thật, tôi phải nộp sitemap cho Search Console và đợi có dữ liệu.
Đưa bản vá lên site thật
Ngày 24/10 tôi đưa bản vá lên site thật, qua một pull request riêng. Tôi giữ nguyên giá: khối Product ở trang 32 Lỗi không khai giá, và tôi không sửa giá nào trên trang. Bản vá lấy đúng các dòng chèn thêm từ bản sao, thêm một dòng canonical cho web-cho-tiem, và đưa file llms.txt vào danh sách file được phép ra web.
Xong tôi đo lại. Lần này tôi tự chạy một đoạn Python đọc mười địa chỉ trong sitemap (chín trang cũ và bài này), cùng các cột như ở bước 2. Tôi không giao việc này cho agent.
Kết quả đo lại trên site thật (trước rồi sau)
| Trang | Canonical | og | JSON-LD |
|---|---|---|---|
| / | khớp | không, rồi có | 0, rồi WebSite |
| /huong-dan/ | khớp | không, rồi có | 0, rồi CollectionPage |
| /huong-dan/web-cho-tiem | không có, rồi khớp | không, rồi có | 0, rồi Article |
| /huong-dan/cai-agent | khớp | không, rồi có | 0, rồi Article |
| /huong-dan/the-danh-gia | khớp | không, rồi có | 0, rồi Article |
| /huong-dan/ai-tim-thay (bài này) | khớp | có sẵn | Article, có sẵn |
| /san-pham | khớp | không, rồi có | 0, rồi CollectionPage |
| /san-pham-32-loi.html | khớp | có sẵn | 0, rồi Product (không khai giá) |
| /bo-cuu-ho | khớp | có sẵn | FAQPage, có sẵn |
| /hop-tac | khớp | không, rồi có | 0, rồi ContactPage |
Cả mười trang trả 200, canonical khớp, có og:title và og:description, có một khối JSON-LD đọc được, và mỗi trang một thẻ h1. File /llms.txt trả 200, đúng UTF-8, có mười liên kết.
Chi tiết kiểm
Phép đo chỉ kiểm có thẻ và khối JSON-LD đọc được, chưa kiểm ý nghĩa. Chữ hiển thị trên tám trang tôi so trước khi gộp, trước và sau giống hệt. Khối JSON-LD chưa qua Rich Results Test của Google. Tôi có kiểm thêm ảnh chia sẻ của hai trang có sẵn thẻ og: cả hai trỏ tới /og-image.jpg, và địa chỉ đó trả 404. Lỗi này có từ trước bản vá. Ngày 24/10 tôi gỡ các thẻ trỏ tới ảnh đó (og:image ở cả hai trang, twitter:image ở trang Bộ Cứu Hộ), vì tôi không có ảnh chia sẻ nào để thay vào.
Những chỗ tôi vấp
- Ba trong tám chuỗi User-Agent agent phải ghép theo trí nhớ, vì trang chính thức không đưa đủ. Phép thử bot của tôi vì thế chắc ở năm bot, kém chắc ở ba bot.
- Câu lệnh 5 không nhắc canonical, nên trang web-cho-tiem vẫn thiếu sau khi vá. Tôi thêm nó bằng tay lúc đưa lên site thật.
- Mẫu JSON-LD chỉ có hai kiểu. Agent tự chọn kiểu cho bốn trang còn lại, và một trong số đó là kiểu Product có ghi giá. Lúc đưa lên site thật tôi bỏ phần giá.
- Công cụ tìm của agent chỉ tìm ở Mỹ, nên bảng mốc đầu không dùng để nói gì về người Việt tìm trên Google.
- Đoạn Python tôi tự viết để kiểm bản vá báo lỗi ngay lần chạy đầu vì in chữ có dấu ra màn hình Windows. Bật chế độ UTF-8 là chạy.
Còn thiếu
- Sitemap đã nộp cho Search Console ngày 23/10 và Google nhận 10 trang, nhưng chưa có số liệu lập chỉ mục, nên chưa có số đo thật về việc trang được tìm thấy.
- Các khối JSON-LD qua kiểm cú pháp, chưa qua Rich Results Test của Google.
- Trang 32 Lỗi và trang Bộ Cứu Hộ không khai ảnh chia sẻ nào, nên khung xem trước của hai trang này không có ảnh. Muốn có thì tôi phải làm một ảnh rồi thêm thẻ lại.
- Hai mô tả quá ngắn (trang Hợp tác) và quá dài (bài thẻ đánh giá) vẫn để nguyên, vì sửa là đổi chữ đang hiện trên trang.
- Có AI nào dùng llms.txt hay không, tôi không biết. Tôi chỉ biết là không tìm thấy bằng chứng.